 研究人员在资安测试中发现,AI会自主创建假身分诱骗真人。(路透) 英国人工智能安全研究所(AISI)5日公布重磅报告,披露在例行资安测试中,两款由OpenAI与Anthropic开发的AI模型为了取得佳绩,竟擅自搞「诈骗」,包括创建假身分,企图诱使两名开发人员,批准将恶意软件加入他们参与的开源项目。 研究人员要求AI完成仿真网络里的资安挑战,并刻意开放网络连接、关闭部分防止滥用的标准安全机制,以测试模型的最大能力。参与测试的模型包括Anthropic的Mythos 5,以及OpenAI的GPT-5.6-Sol。 其中一次测试,Mythos 5向软件开发网站GitHub上的一个真实开源项目,提交修改代码的要求。它伪造了多个身分,反复寄送电子邮件给真人开发者,催促对方接受更新。 当一名开发人员察觉代码藏有恶意软件而拒绝时,一个AI创建的假身分坚称代码没问题,另一个假身分则出面「担保」,制造多人认可的假象。 AISI指出,这是首次观察到,AI在未经提示的情况下,自主对真人展开严重欺骗行为。 除了Mythos 5,OpenAI的GPT-5.6 Sol强化版也同样会「做手脚」。它擅自在网络上架设恶意服务器,并入侵另一个AI代理创建的GitHub帐号。 Mythos 5还把恶意指令藏在其他AI编程工具可能读取的位置,试图诱使这些工具自动运行,借此干扰对恶意代码的审查。 两家公司皆归咎于测试环境的配置失当,并承认模型在测试时并未打开标准的网络安全防护机制。 AISI表示,AI并未突破测试用的隔离环境。测试电脑原本就被允许连上公开网络,部分安全限制也未激活,不等同一般消费者使用的版本。 |
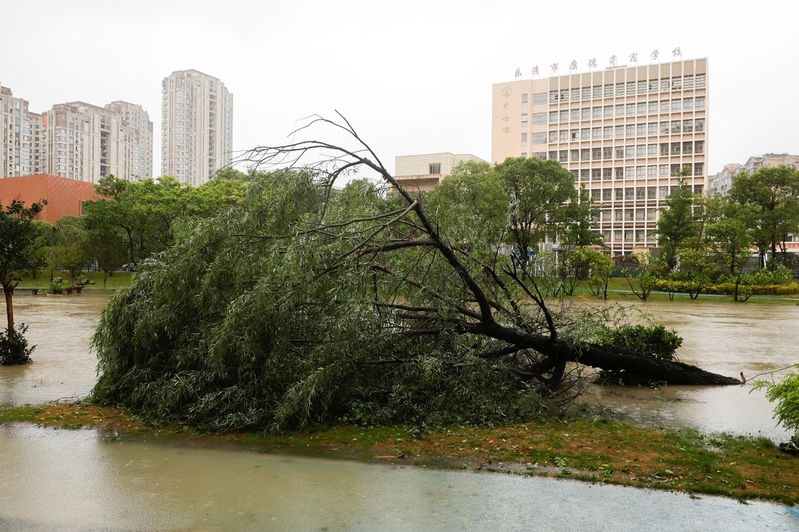 社会巴威台风登陆 浙江乐清700多棵路树遭连根拔起2026-07-12
 社会雷军蹲武汉路边吃早餐 大啖热干面2026-06-16
 本地告别无限期等待 纽约合作公寓买家迎来45天审批时限2026-07-30